SWE-Pruner Pro: Read Its Mind, Not Its Output
引言
在之前 blog 里,我们分享了 SWE-Pruner —— 一个 0.6B 的代码语义高亮模型,靠 context focus question包装工具输出,在 SWE-Bench / SWE-QA 上把 token 砍掉 30%+ 而几乎不损质量。
开源之后,我们被问到最多的两个问题是:
- Engineer常问的是,我如何将SWE-Pruner接入他们已有的工作流?
- Researcher常问的是,SWE-Pruner可以和基座一起Scale吗?
对于1, 当我们给出 context focus question 或者原生 Code Execution 的回答之后,有些人想了想,表示可以适配,还有人面露难色,对于工具进行侵入式修改不一定对于所有场景都可行。
对于2,我们当时只能承认,Pruner的Scale能力在于: 更好的标签,更好的基座工具调用能力,但截至我们做Pruner实验的时候,许多次旗舰模型依然无法正确的产出question,而给一个模型可能已经完全“肌肉记忆”的工具加上额外的参数可能是反模型的(例如, 给Bash加question)
受这些社区反馈启发,我们当时产生了一个灵感:
已知:
- 外挂一个模型无法解决这些问题
- 模型能够产出question,说明模型其实知道它想要保留什么
- 已有相当多研究表明,模型的hidden state其实编码了后续多个token的信息
那为什么不把Prune做到基座模型里面去呢?
从这个角度来看,question似乎是绕了个远路,如果模型能够在hidden state里面编码它想要输出什么样的question, 想要什么样的输出,那我们就不需要依赖于模型适用文本输出question,再去修改工具适应一个外部的pruner模型。这本质和Agentic search的困境是一样的, 基座的能力需要向搜索小模型适应这件事情本身就是非常不优雅的。
所以,在经过了数个月的探索之后,我们做了新的SWE Pruner Pro,问题是一个问题,解法是完全不同的解法。
问题
不再赘述Context Prune的重要性。我个人是认为Prune会是Long Horizon的未来组件的, 并且, 让LLM自己操作history是大势所趋, 而Prune或许是其中最简单,最可验证的一步。
架构设计
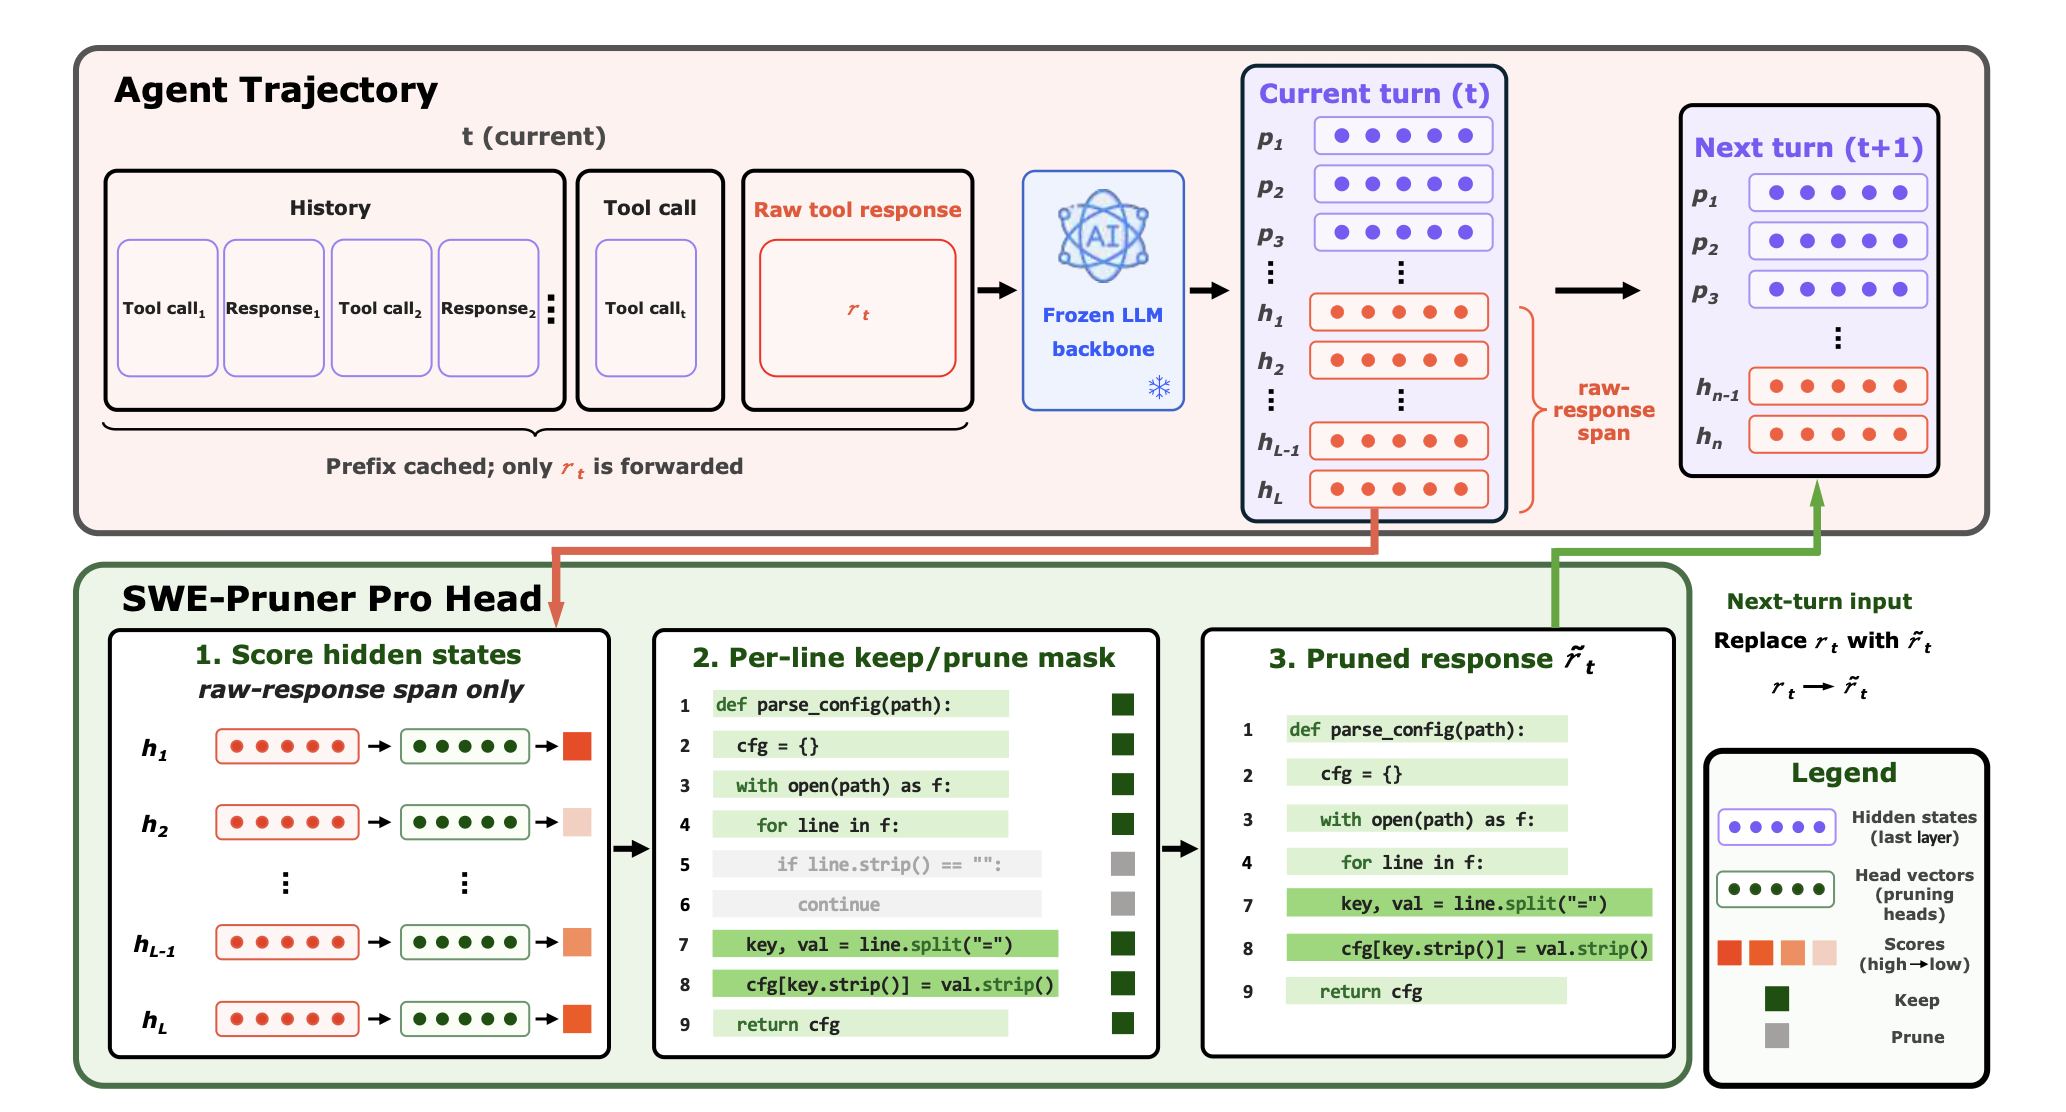
如图,省流就是LLM backbone正常推理,推理时带出hidden state,针对这个hidden state → 裁剪与否的映射进行训练。
另一个问题就是使用哪个区域的hidden state? 我们使用tool response区域的hidden state。即,模型在发起tool call,收到tool response之后,进行一个 1-token forward, 算出裁剪后的新tool response,替换后再正常继续推理
数据集
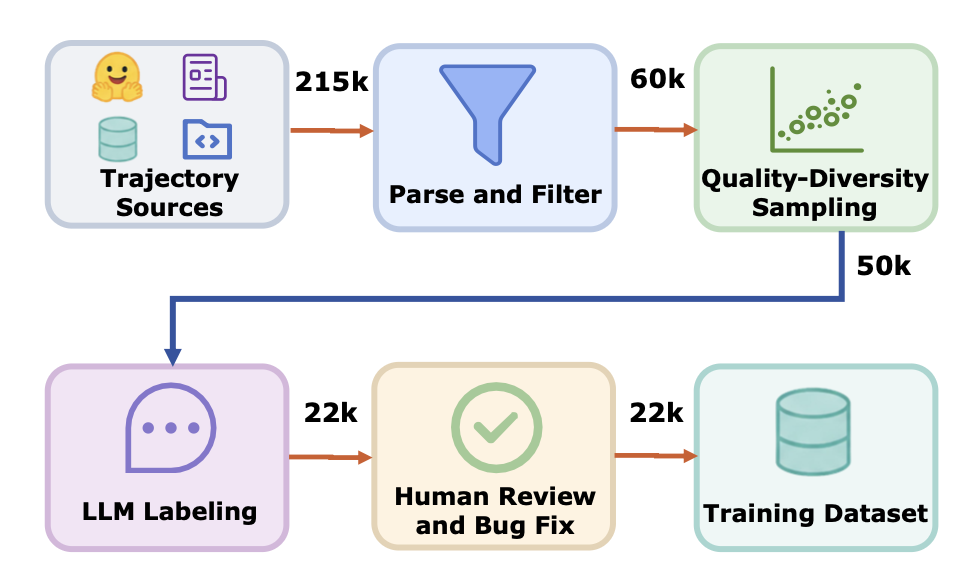
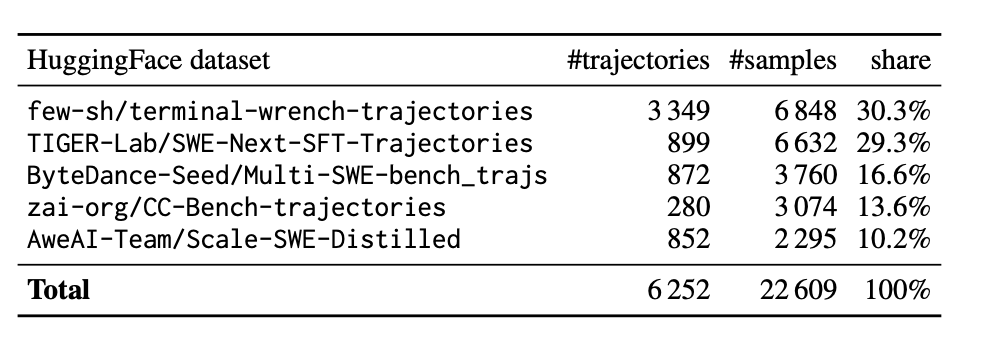
见论文中的一图一表,一个值得指出的是,因为上面使用hidden state的架构设计,我们需要保持hidden state和真实推理环境类似,所以需要多轮轨迹数据,而不是之前Pruner的单轮数据
没有question之后出现的一个麻烦是不好标注Prune/Kept了,我们的解法是使用AgentDiet同款: 令标注模型看历史和未来若干步,然后根据 “当前步对历史和未来的影响” 来打保留/裁剪的标,标注使用Claude Sonnet 4.6完成,弱模型有点标不明白
训练
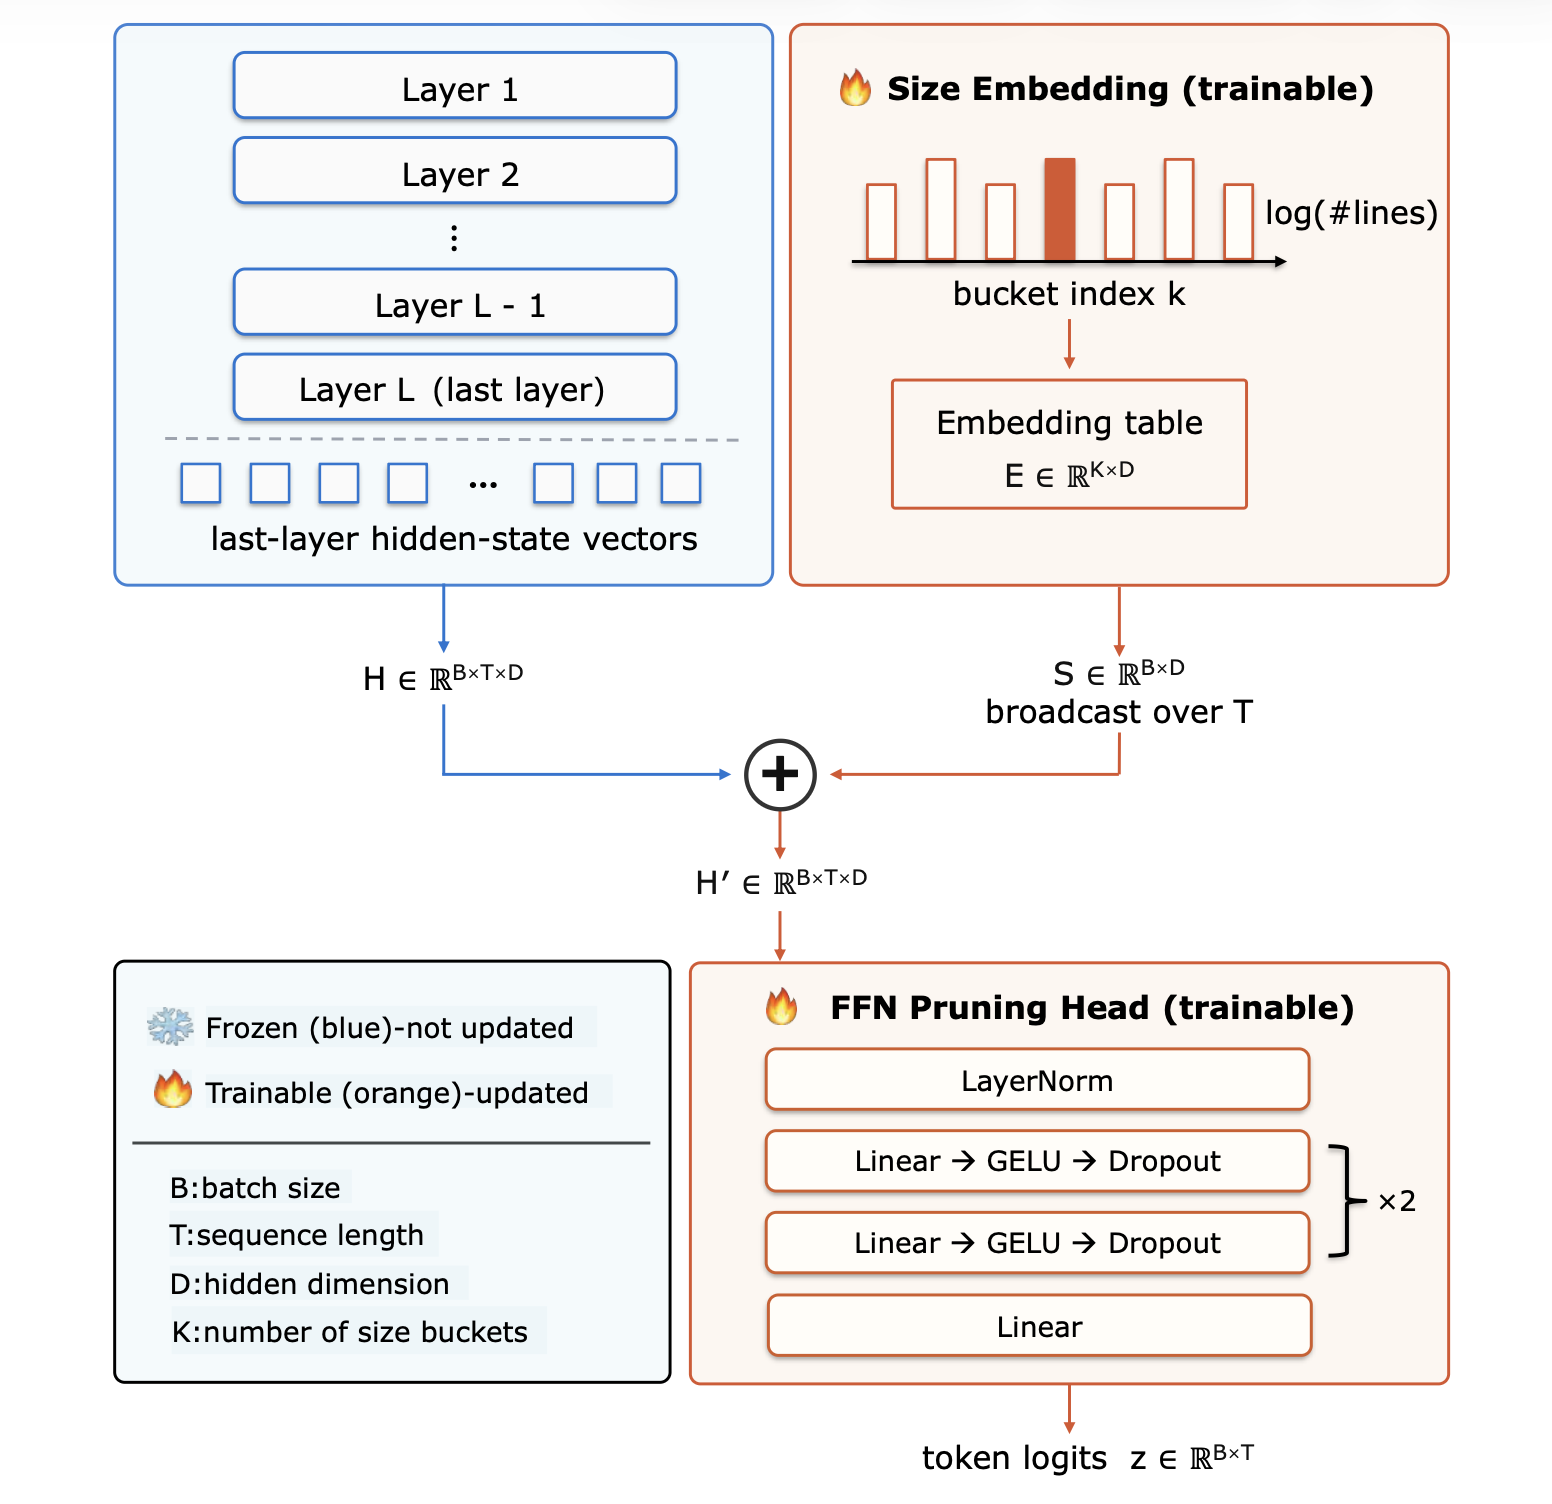
训练本身没有太多好说的, 这个任务本质就是一个 Feature → 0/1 label 的经典ML任务
使用SWE Pruner同款Head也问题不大,但我实测CRF头不是很稳定,可能是因为没有显式question之后本身决策就多了一些模糊的成分。所以FFN就行。
我觉得比较重要的是两个新加入的小巧思,即论文中的size embedding和per sample balanced focal loss
size embedding的作用是, 让模型对需要裁剪的内容长度有感知, 朴素的想法是, 长的可以多裁,短的可以考虑放宽,起到一个自适应阈值的作用
而loss的改造则基于这样的观察: 看起来这是一个二分类问题,但实际上,Prune和Keep的作用不是平等的!
如果一个gt之中,100行keep了3行, 则这三行的漏召回会比其他行的误召回影响更大
也就是说,一个样本keep的行数本身,就带有一定的重要性信息,打标模型越强,留的越“骨架”,留下的部分就越重要。
所以基于这样的观察,就可以对Focal Loss做一些更保少数类召回的改造,即我们论文里的
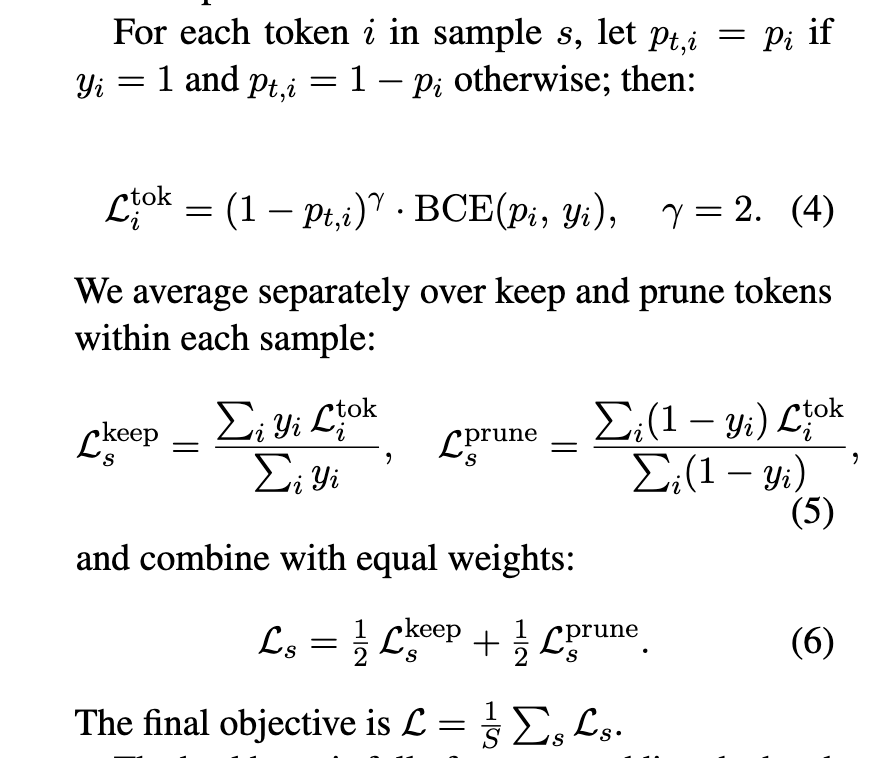
本质上,强制Prune 类的召回和Keep类的召回一样重要: 如果只有少数Prune,那这几行Prune的是模型觉得更应该删去的(不然由于连贯性的考量,会标注为丢弃这个样本);如果只有少数Keep,那这几行是模型觉得更应该保留的
推理
推理的关键在于两个:
- 如何带出hidden state
- 如何适配Agent层
对于1,可以看我们论文里面的Appendix E, 详细地讲述了如何在sglang里面相对高效的支持这样的需求。走裸transformer慢得无法接受,走vllm只支持offline extract,但我们这套逻辑要求online serving —— sglang 改起来更简单一点,相对来说。(但也有相当多的patch,瘫,这个feature没什么人用,很多模型适配/和其他的feature的适配都一点没做)
对于2,我们的动机就是Agent层零适配。但其实坦白讲,也不能做到完全零适配 —— 我们这个头总要给Agent留一个开关,总不能所有工具调用都进行裁剪 —— 假如把 echo 裁剪掉了是相当“令模疑惑”的。现在的实现就是模型可以直接输出一个特定的标识符“SKIP PRUNE IN NEXT X TURNS”,Agent框架检测到标识符之后bypass接下来的X轮。
为什么不… (FQA)
附上一些论文里面没讲的消融
Q: 为什么不用全history的hidden state?
A: 没想到什么好的架构,变成一个变长的东西了;并且,性能有一定影响
Q: 为什么只用最后一层
A: 主要是考虑到性能和支持问题,最后一层的hs的网络传输量已经很大了,如果全layer或者走SWE Pruner的多层融合会成倍加上时间开销,并且主流推理引擎都不支持返回多层。此外,我在小样本集上做了实验,在所有层之中挑最优/选最后一层/所有层softmax融合性能基本没什么区别。
Q: 为什么不用残差流
A: 推理支持问题,加上不做可解释不太熟
Q: 为什么选这几个模型
A: 想选glm的,适配半天没适配出来,qwen是最好适配的。kimi linear也适配不出来。工程难度太大了…… mimo 300B已经很大了,跑实验的资源开销有点大。如果没有自定义serving engine跑swebench等bench的需求,是想跑更大更主流的模型的,比如几个1T的开源。
Q: 为什么不做可调阈值
A: 因为发现没人调,直接在模型层size embedding完成更好
Q: 为什么用这些数据集
A: 找不到更好的数据了, … 开源的好轨迹太少了, 很多都没有thinking之类的, 甚至和推理都还有很严重的不一致…… 已经连网安任务的轨迹都大量拿来用了,好轨迹肯定更好
Q: 为什么不报单次latency
A: 因为Pruner有明确的latency随output token曲线,而Pruner Pro本质的latency是一次TTFT,一是强绑定历史长度,二是随负载和引擎策略有巨大方差……自己mock没啥意义,就选了几条实际的轨迹汇报端到端结果
总结
回到引言里那两个问题
- Engineer 关心的接入:Pro 这条路把裁剪的开关从工具参数挪进了模型里,Agent 框架侧只剩一个 bypass 标识符,相比前作那种侵入式包装要干净一些
- Researcher 关心的 Scale:基座越强,hidden state 编码的 keep/prune 信号就越清晰,所以 Pro 会更能跟着 backbone 一起 scale,而不再卡在 "agent 会不会写 question"
整篇blog留下的另外一个观点是:让一个独立小模型重新算 backbone 已经算过的东西,是 Agentic 系统里一个被普遍接受、但其实并不优雅的范式。Pruning 只是这条路上最容易验证的一步,其它任务大概也能走类似的路 —— 前提是推理引擎愿意把 hidden state 当成 first-class。等将来这方面的基础建设完善之后, 相信会出来更多有趣的应用和研究实践,比研究如何写更好的压缩prompt总是有意思多了。
Read Its Mind, Not Its Output. 做完了之后回看, 从Pruner到Pruner Pro又类似Provence到Oscar了,还是很有趣的。